 Welcome to the hobbang world
문제상황
홍조와 여드름을 동시에 예측하는 Multi Task Learning 모델을 만들고 있었다.
구조는 단순하다.
이미지 1장 → EfficientNet backbone → ┬→ 홍조 head → 홍조 등급
                                     └→ 여드름 head → 여드름 등급
문제는 두 task의 학습 데이터 형태가 서로 달랐다는 점이다.
- 홍조: 얼굴 전체 이미지
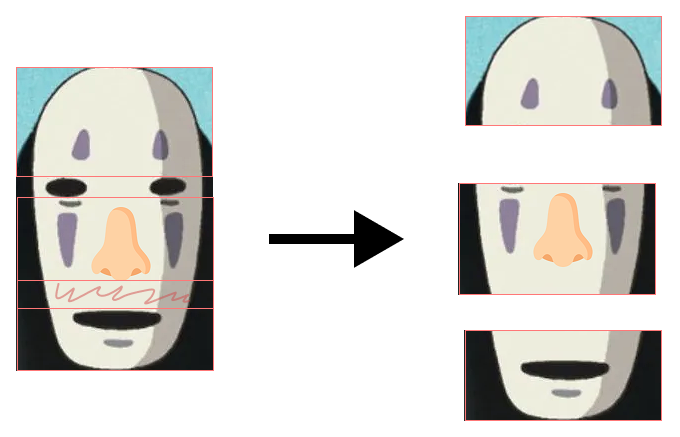
- 여드름: 개인정보 이슈로 원본 없이 crop 이미지만 제공됨. 한 얼굴이 [forehead, nose, mouth, left, right] 다섯 부위로 잘려 있음.
여드름 등급은 detection box의 개수로 결정되는 구조였다.
예를 들어 박스가 0~5개면 good, 5~10개면 medium, 10개 이상이면 bad 식의 중증도 분류이다.
즉, 이 task의 라벨 정확도는 여드름을 몇 개로 세느냐에 달려 있었다.
하나의 backbone에서 한 쪽 head는 전체 이미지로, 다른 한 쪽은 여러 형태(전체 이미지, crop 이미지)로 입력될 수 있는 상황. 입력을 어떻게 통일할 것인가가 첫 번째 과제였다.
첫 번째 접근: MIL 검토와 기각
처음엔 클로드와 대화를 통해 MIL(Multiple Instance Learning) 기법을 활용하려고 했다.
bag 단위로 N장의 이미지를 묶어서 예측하는 구조라면, 부위별 crop 여러 장을 한 묶음으로 보고 학습을 시킬 수 있지 않을까 싶었다.
그런데 MIL이 실제로 풀어주는 문제를 들여다보니 내 상황과 맞지 않았다.
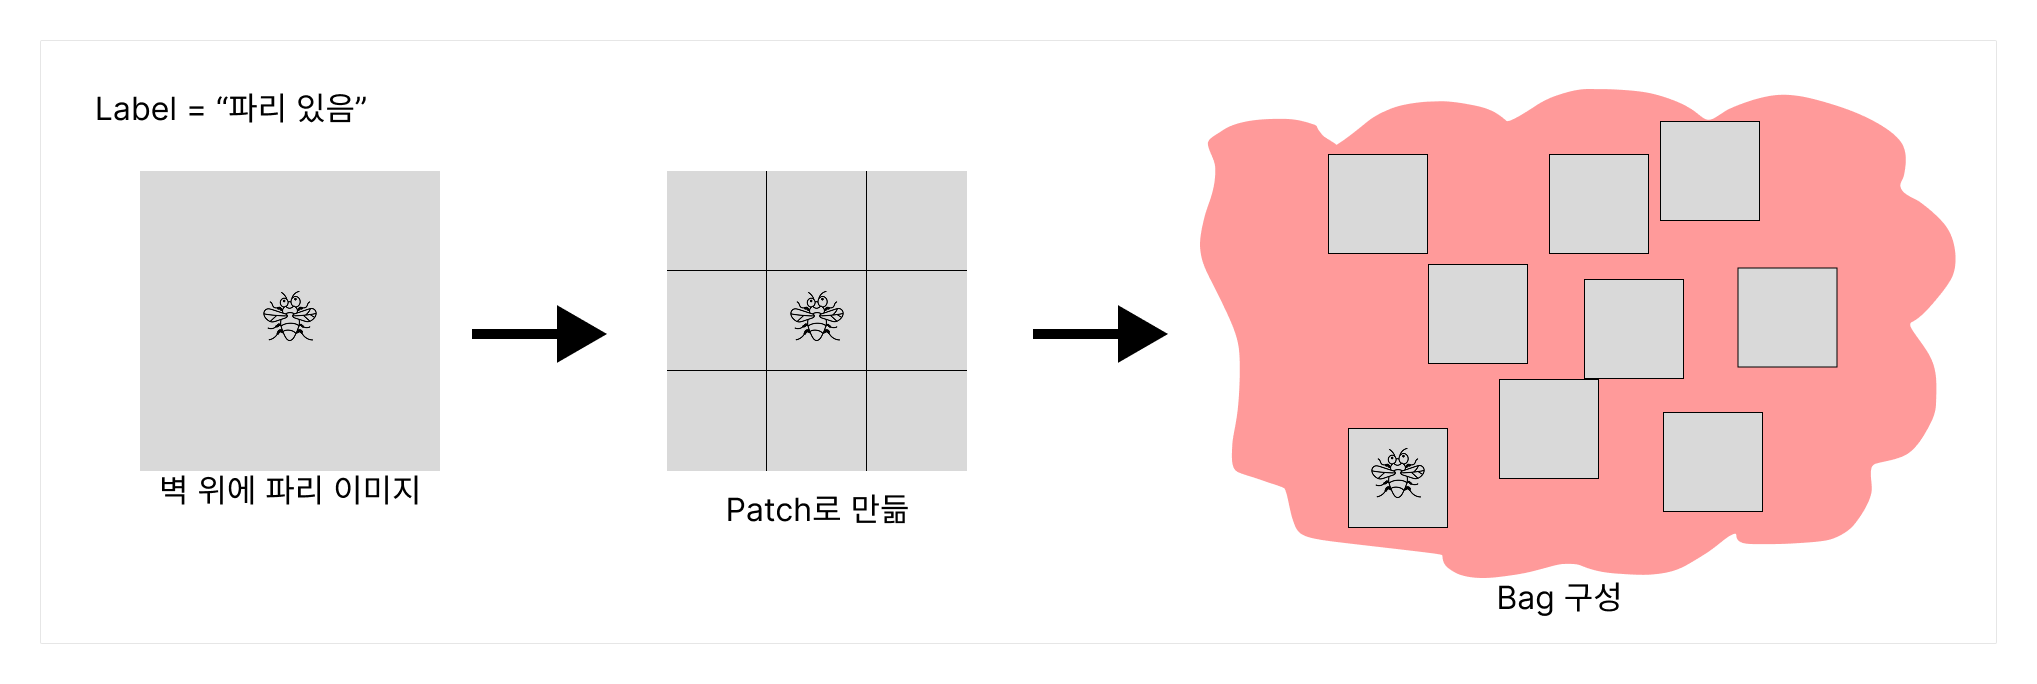
MIL은 “여러 장을 본다”가 아니라 라벨이 bag 단위로만 존재하는 weak supervision 상황을 다루는 데 있다.
병리 슬라이드 한 장에 “암 있음/없음” 라벨만 있고 그 안의 어떤 패치가 암인지는 모를 때, 모델이 스스로 “어떤 인스턴스가 결정적인지”를 추론하게 하는 것이 MIL이다.
예시: 벽 위에 파리가 있는 사진이 있고, 그 사진에 “파리 있음” 라벨만 달려 있는 상황. 모델이 사진의 어느 부분이 파리인지 모르는 상태에서, 여러 패치 중에서 파리가 있을 법한 패치를 찾아내는 것이 MIL의 문제 설정이다.
내 문제는 반대 상황이었다.
- 라벨 구조 관점: 각 crop의 위치(forehead/nose/mouth/left/right)도, 그 안의 여드름 박스도 이미 다 알고 있었다. weak supervision 상황이 아니다. MIL을 쓰면 이미 가진 강한 라벨 정보를 일부러 버리고 약한 가정으로 내려가는 셈이다.
- 방향 관점: 나는 인스턴스(각 부위의 박스 개수)를 정확히 세어 bag(얼굴 전체) 등급을 만들어야 한다. MIL은 bag 라벨에서 인스턴스 기여를 역으로 추론한다. 방향이 반대다. 내게 필요한 건 “정확한 카운팅”이지 “어느 인스턴스가 중요한지 추론”이 아니다.
- 입력 분포 관점: 더 근본적으로, 전체 이미지와 부위 crop은 backbone이 보는 입력 분포 자체가 갈라진다. MIL은 이 이질성을 해결해주지 않는다.
결론은 MIL 기각. 입력 분포를 먼저 통일하는 것이 순서였다.
방향 전환: 입력 스케일 통일
MIL을 공부하던 모습을 보고 교수님의 피드백은 “입력 형태가 다르면 모델 전처리에서 통일해라”였다.
단순한 원칙이었다.
crop으로 갈 거면 전부 crop
전체로 갈 거면 전부 정합.
둘을 섞지 않는다.
두 방향 중 전체 이미지로의 정합을 택했다. 이유는 crop 알고리즘이 블랙박스였기 때문이다. 제공된 crop 이미지가 어떤 기준으로 잘렸는지 알 수 없는 상황에서, 홍조용 전체 이미지를 crop 형태로 맞추려면 그 미지의 알고리즘을 역으로 재현해야 한다. 반대로 crop들을 원본 형태로 다시 붙이는 쪽이 훨씬 통제 가능했다.
추정 원본 이미지:
게다가 이 선택은 또 하나의 문제를 동시에 풀어줬다. 바로 여드름 개수 라벨의 정확도다.
[forehead, nose, mouth] crop들은 한 장의 원본에서 잘려나온 것으로 보였고, 특히 nose와 mouth 구간에 겹치는 영역(overlap)이 있었다. crop을 그대로 쓰면 overlap 영역의 여드름이 양쪽 crop에 모두 잡혀 이중 카운트되고, 그러면 개수가 부풀려져 중증도 등급이 오염된다. 즉 정합은 “이미지를 예쁘게 붙이는” 작업이 아니라 라벨 무결성을 지키는 작업이기도 했다.
정리하면, 한 번의 정합이 두 가지 문제를 동시에 풀었다.
- 입력을 전체 이미지로 통일 (모델 입력 일관성)
- overlap 중복 박스 제거 (여드름 개수 = 등급 라벨의 정확도)
ZNCC 기반 이미지 정합
정합에는 ZNCC(Zero-mean Normalized Cross-Correlation)를 사용했다. crop들이 같은 원본에서 잘려나왔기 때문에 밝기·스케일이 동일하고, 따라서 픽셀 단위 상관으로 겹침 구간을 찾는 것이 잘 맞을 것이라 판단했다.
- 각 이미지 경계(상-중, 중-하)에서 ZNCC가 최대가 되는 지점을 찾아 겹친 픽셀 수를 추정한다.
- 그 구간을 선형 가중치(그라데이션 가중치)로 섞어 이음매를 없앤다.
- ZNCC가 임계치보다 낮으면 겹침이 없다고 보고 단순 적층으로 붙인다.
핵심 로직은 이렇다.
# Pseudo-code
def align(top_img, bottom_img, threshold):
    best_offset, best_score = None, -1
    # top의 하단 경계와 bottom의 상단 경계가 겹치는 후보 구간 탐색
    for overlap in candidate_overlaps:
        score = zncc(top_img[-overlap:], bottom_img[:overlap])
        if score > best_score:
            best_score, best_offset = score, overlap

    # 정합 점수가 threshold보다 낮으면 겹침이 없다고 보고 단순 적층으로 붙인다.
    if best_score < threshold:
        return stack(top_img, bottom_img)

    # 겹친 구간을 선형 가중치(그라데이션 가중치)로 블렌딩하여 이음매 제거
    return blend(top_img, bottom_img, best_offset)
실제로 돌려보니 특정 패턴이 나왔다. forehead-nose 경계는 대부분 단순 적층으로 처리됐고, nose-mouth 경계에서는 정합이 일어났다. 이는 원본 한 장에서 잘라내는 과정에서 nose와 mouth 구간만 겹치게 잘렸다는 추론의 근거가 됐다.
재구성 이미지:
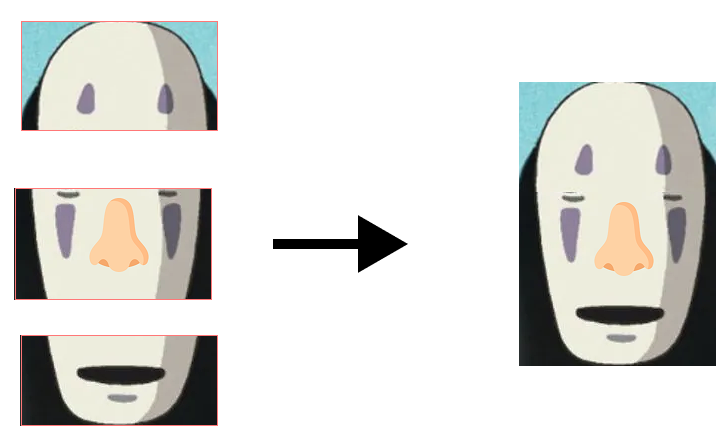
먼저 claude로 단일 이미지용 예시 코드를 작성한 뒤, 이를 로컬의 대규모 데이터셋 처리용 코드로 변환해 preprocessing을 완료했다.
남은 과제: detection box 중복 병합
이미지를 붙이는 것만으로는 끝이 아니다. overlap 구간에 걸친 여드름 detection box는 여전히 두 번 카운트될 수 있다. 이를 box center 좌표 사이의 거리로 판단해, 일정 거리 이내의 박스는 같은 여드름으로 보고 하나로 병합하는 작업을 진행 중이다. 이 처리가 끝나야 여드름 개수가 비로소 정확해지고, 중증도 등급 라벨이 신뢰할 수 있는 값이 된다.
회고
claude는 “부위별 crop 여러 장 → 하나의 등급 예측”이라는 구조를 보고 MIL을 꺼냈다. 표면적으로는 맞는 매칭이었다. 하지만 내 문제의 실제 병목인 이미 강한 라벨이 있음, 정확한 카운팅이 필요함, 입력 분포가 갈라져 있음과는 결이 달랐다.
교수님은 기법이 아니라 제약을 먼저 봤다. “입력이 다르면 모델 전에 맞춰라.” 이 한 마디가 MIL 같은 구조적 해법이 아니라 전처리 정합이라는 훨씬 단순하고 근본적인 방향을 열었다. 그리고 그 정합이 입력 일관성뿐 아니라 라벨 정확도까지 동시에 잡아준다는 건 실제로 구현하면서 확인한 것이었다.
결국 차이는 “어떤 기법을 아느냐”가 아니라 “문제의 진짜 병목이 어디인지 짚을 수 있느냐”였다. 기법은 검색하면 나오지만, 지금 이 문제에서 뭘 먼저 풀어야 하는지를 판단하는 눈은 도메인 경험에서 온다. 나도 그런 판단력을 길러야할 것 같다.